رقمنة
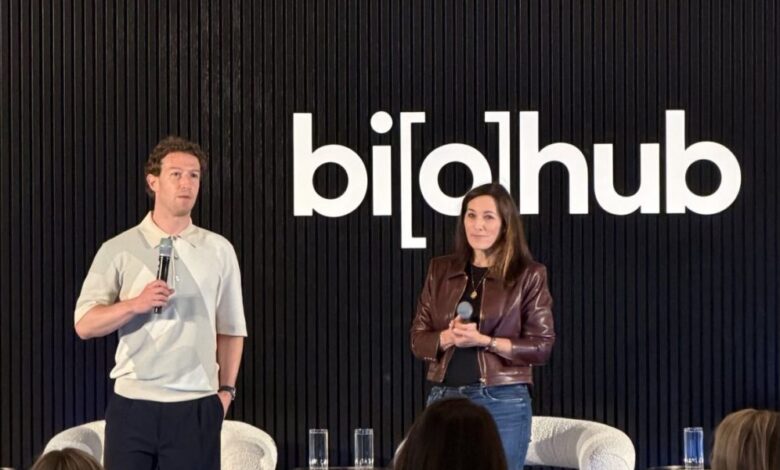
أعلنت Biohub، المؤسسة البحثية غير الربحية المدعومة من Mark Zuckerberg وزوجته Priscilla Chan، توسيع مبادرة بحثية ضخمة تهدف إلى بناء قاعدة بيانات بيولوجية مفتوحة ومهيأة لتدريب نماذج الذكاء الاصطناعي، بقيمة إجمالية تصل إلى 1.8 مليار دولار من التمويل والبيانات والقدرات الحاسوبية وتقنيات القياس.
وتجمع المبادرة الجديدة، التي تحمل اسم Virtual Biology Initiative، بين Biohub ووزارة الطاقة الأمريكية DOE وNational Institutes of Health (NIH)، إلى جانب Google DeepMind وMeta وIsomorphic Labs، في محاولة لمعالجة واحدة من أكبر العقبات أمام تطوير الذكاء الاصطناعي في علم الأحياء، وهي نقص البيانات البيولوجية المنظمة وعالية الجودة اللازمة لتدريب النماذج.
الذكاء الاصطناعي يدخل مرحلة البيولوجيا
تقوم الفكرة الأساسية للمشروع على إنشاء كمية هائلة من البيانات التي تصف كيفية عمل الخلايا واستجابتها للتغيرات والتدخلات المختلفة، ثم استخدام هذه البيانات لتطوير نماذج ذكاء اصطناعي تستطيع التنبؤ بسلوك الأنظمة البيولوجية.
وتستهدف المبادرة الوصول في النهاية إلى نموذج قادر على بناء صورة رقمية أكثر دقة للخلية، بحيث يستطيع الباحثون استخدام الذكاء الاصطناعي لمحاكاة بعض التجارب البيولوجية قبل تنفيذها في المختبر.
وإذا نجحت هذه الرؤية، يمكن للباحث أن يختبر بصورة رقمية تأثير دواء أو تغير جيني أو تدخل بيولوجي معين، ثم يوجه التجارب المخبرية نحو النتائج الأكثر وعداً.
وترى Biohub أن امتلاك نموذج تنبؤي دقيق للبيولوجيا يمكن أن يغير طريقة إجراء الأبحاث الطبية، عبر تقليل الوقت والتكلفة المطلوبة للوصول إلى اكتشافات جديدة في الأمراض والعلاجات.
1.8 مليار دولار لمشروع واحد
تبلغ القيمة الإجمالية المعلنة للمبادرة نحو 1.8 مليار دولار، لكن هذا الرقم لا يمثل تمويلاً نقدياً جديداً من جهة واحدة.
فالالتزام يجمع بين استثمارات نقدية جديدة، وبيانات بحثية موجودة بالفعل، وقدرات حوسبة، وتقنيات قياس وتصوير متقدمة.
وتلتزم Biohub نفسها بنحو 500 مليون دولار لدعم المبادرة على مدى خمس سنوات، فيما ستستثمر DOE أكثر من 500 مليون دولار خلال خمس سنوات في أعمال القياس البيولوجي والنمذجة والحوسبة.
وفي الوقت نفسه، ستوفر NIH مجموعات بيانات ومستودعات ومعارف تم تطويرها من خلال أكثر من 500 مليون دولار من الاستثمارات الفيدرالية السابقة، مع العمل على توحيد هذه الموارد وجعلها أكثر ملاءمة لتدريب نماذج الذكاء الاصطناعي.
أما Google DeepMind وMeta وIsomorphic Labs، فتساهم مجتمعة بنحو 300 مليون دولار في المبادرة.
Biohub تقود البنية البحثية
كانت Biohub قد أطلقت Virtual Biology Initiative في أبريل 2026، مع التزام أولي بقيمة 500 مليون دولار لمدة خمس سنوات.
ويخصص نحو 400 مليون دولار من هذا الالتزام لتطوير تقنيات جديدة توسع قدرة العلماء على قياس ما يحدث داخل الخلايا وعلى مستويات مختلفة من التنظيم البيولوجي، فيما يخصص نحو 100 مليون دولار لأبحاث خارجية.
وتشمل التقنيات المستهدفة التصوير المجهري المتقدم، وcryo-electron tomography التي تتيح دراسة تفاصيل قريبة من المستوى الذري داخل الخلايا، إلى جانب أدوات هندسة بيولوجية يمكن استخدامها للتعامل مع البيولوجيا على مستويات جزيئية وخلوية ونسيجية وحتى على مستوى الكائن الحي.
الهدف من هذه الاستثمارات هو إنتاج البيانات التي تحتاج إليها نماذج الذكاء الاصطناعي حتى تتجاوز مرحلة وصف المعلومات البيولوجية إلى محاولة فهم العلاقات بين المتغيرات والتنبؤ بالنتائج.
DOE تضيف قوة الحوسبة
تدخل Department of Energy الأمريكية إلى المشروع بقدرات تتجاوز التمويل المالي، إذ ستوفر منظومة من المختبرات الوطنية والبنية التحتية الحاسوبية والتقنيات العلمية اللازمة لجمع وتحليل البيانات البيولوجية.
وتعتزم الوزارة استثمار أكثر من 500 مليون دولار على مدى خمس سنوات ضمن جهود تشمل جمع البيانات، والقياس والتصوير، وتحليل البيانات بالذكاء الاصطناعي، والنمذجة، والحوسبة.
كما ستستفيد المبادرة من قدرات الحوسبة فائقة الأداء، وتقنيات الأشعة السينية والنيوترونات، والمجاهر الإلكترونية بالتجميد، وتقنيات التصوير المتقدمة، إلى جانب مختبرات ذات قدرات آلية.
وتمنح هذه الموارد المشروع قدرة على معالجة حجم من البيانات والتجارب يصعب على مؤسسة بحثية واحدة توفيره بمفردها.
NIH تفتح مستودعات البيانات
تقدم NIH نوعاً مختلفاً من الموارد، إذ ستنسق مساهمات تتضمن مجموعات بيانات ومستودعات وقواعد معرفة نشأت من استثمارات فيدرالية سابقة تجاوزت قيمتها 500 مليون دولار.
وتضم هذه الموارد قواعد ومستودعات طبية وبحثية مرتبطة بـNational Library of Medicine وNational Center for Biotechnology Information، إضافة إلى برامج بحثية تعمل على تطوير أطالس بيولوجية ومعايير مشتركة وبيانات مهيأة لاستخدامات الذكاء الاصطناعي.
وستعمل Biohub مع NIH على توحيد هذه البيانات، بحيث تصبح قابلة للاستخدام بصورة أكثر اتساقاً في تدريب النماذج.
وتعد عملية التوحيد من أهم أجزاء المشروع، لأن البيانات البيولوجية المتاحة حول العالم جُمعت عبر مؤسسات ومختبرات وبرامج مختلفة، وغالباً ما تختلف طرق قياسها وتصنيفها وتخزينها.
Google DeepMind تراهن على البيانات
تشارك Google DeepMind في المشروع باعتبارها واحدة من الجهات التي تعمل على تطوير الذكاء الاصطناعي للعلوم، وترى أن بناء نماذج قادرة على فهم البيولوجيا يحتاج إلى بيانات تجريبية مفتوحة وعلى نطاق غير مسبوق.
وتساهم Google DeepMind مع Meta وIsomorphic Labs بنحو 300 مليون دولار في المبادرة، بهدف تطوير التقنيات ومجموعات البيانات متعددة الأنماط اللازمة لبناء نماذج قادرة على التنبؤ بسلوك الأنظمة البيولوجية.
وتعكس مشاركة هذه الشركات انتقال المنافسة في الذكاء الاصطناعي إلى مجالات علمية جديدة، حيث لم تعد القدرة على بناء نموذج أكبر مرتبطة فقط بزيادة قوة الحوسبة، وإنما بامتلاك البيانات العلمية التي يمكن للنموذج التعلم منها.
Isomorphic Labs تدخل سباق اكتشاف الأدوية
تكتسب مشاركة Isomorphic Labs أهمية خاصة بسبب تركيز الشركة على استخدام الذكاء الاصطناعي في اكتشاف الأدوية.
وتعمل الشركة على تطوير أنظمة تساعد في فهم التفاعلات البيولوجية وتصميم الأدوية، ما يجعل الوصول إلى بيانات خلوية أكثر تفصيلاً واتساقاً عاملاً مهماً في تطوير نماذجها.
ومن خلال المشاركة في Virtual Biology Initiative، تحصل الشركة على فرصة للمساهمة في بناء قاعدة البيانات التي تحتاج إليها الصناعة، إلى جانب تطوير تقنيات يمكن استخدامها لتحليل البيانات متعددة الأنماط.
ويجمع المشروع بذلك بين المؤسسات البحثية الحكومية وشركات الذكاء الاصطناعي وشركات التكنولوجيا الحيوية في منظومة واحدة تستهدف بناء طبقة بيانات مشتركة لعلوم الحياة.
Meta تربط الذكاء الاصطناعي بالعلوم
تأتي مشاركة Meta في المشروع ضمن توسع اهتمام الشركة باستخدام الذكاء الاصطناعي في مجالات علمية تتجاوز تطبيقات المستهلكين.
وتدعم Meta المشروع مع Google DeepMind وIsomorphic Labs باستثمار جماعي يبلغ 300 مليون دولار.
ويحمل المشروع أهمية خاصة بالنسبة إلى Mark Zuckerberg، الذي أسس Biohub مع Priscilla Chan عام 2016 بهدف تسريع الأبحاث الطبية والبيولوجية باستخدام التكنولوجيا المتقدمة.
وتتحول Biohub عبر المبادرة الجديدة إلى نقطة التقاء بين الأبحاث البيولوجية المتقدمة والبنية التحتية للذكاء الاصطناعي، مع التركيز على إنتاج البيانات التي يمكن للباحثين حول العالم استخدامها.
البيانات تصبح أهم من حجم النموذج
تعكس المبادرة تحولاً مهماً في سباق الذكاء الاصطناعي.
فخلال السنوات الماضية ركزت شركات التكنولوجيا بدرجة كبيرة على بناء نماذج أكبر وتوفير قدرات حوسبة أعلى، بينما أصبح الحصول على بيانات متخصصة وعالية الجودة يمثل تحدياً متزايداً، خصوصاً في المجالات العلمية.
وفي علم الأحياء، تصبح المشكلة أكثر تعقيداً، لأن البيانات لا تتعلق بنصوص أو صور فقط، وإنما بسلوك الخلايا والجزيئات والأنسجة والكائنات الحية تحت ظروف مختلفة.
وتحتاج النماذج إلى بيانات تربط بين التدخل البيولوجي والنتيجة التي أحدثها، حتى تستطيع الانتقال من مجرد التعرف على الأنماط إلى بناء توقعات قابلة للاختبار.
وهنا يأتي دور Virtual Biology Initiative، التي تستهدف إنتاج بيانات جديدة، ودمج البيانات الموجودة، وتطوير طرق أكثر كفاءة لقياس الظواهر البيولوجية.
نحو خلية افتراضية
تتمثل إحدى أكثر النتائج طموحاً للمبادرة في الوصول إلى ما يمكن وصفه بـالخلية الافتراضية.
الفكرة هي تطوير نموذج رقمي يستطيع تمثيل أجزاء كبيرة من سلوك الخلية، ثم استخدامه لإجراء تجارب افتراضية على الأدوية أو التغيرات الجينية أو التدخلات الأخرى.
وتتيح هذه الطريقة للباحثين تجربة عدد كبير من الفرضيات رقمياً قبل الانتقال إلى التجارب الفعلية.
وتشير Biohub إلى أن المبادرة تستهدف توسيع بيانات استجابة الخلايا للتدخلات عبر عدد أكبر بكثير من أنواع الخلايا والظروف مقارنة بما تمت دراسته حتى الآن.
وهذا يعني أن المشروع لا يركز على بناء نموذج واحد فقط، وإنما على إنشاء البنية العلمية التي تسمح للباحثين ببناء نماذج متعددة وتحسينها مع تراكم البيانات.
التجارب الرقمية تختصر الطريق
يمكن للخلية الافتراضية أن تغير الطريقة التي يجري بها جزء من الأبحاث الطبية.
فبدلاً من اختبار آلاف الاحتمالات بصورة مباشرة داخل المختبر، يمكن لنظام ذكاء اصطناعي أن يساعد الباحثين على تحديد التدخلات الأكثر احتمالاً لتحقيق نتيجة معينة.
ويظل الاختبار المخبري ضرورياً للتأكد من صحة النتائج، لكن ترتيب الأولويات يمكن أن يتغير جذرياً إذا أصبحت النماذج قادرة على تقديم توقعات موثوقة.
ومن شأن ذلك أن يقلل عدد التجارب غير الواعدة، ويختصر الوقت المطلوب للوصول إلى مركبات دوائية مرشحة أو تفسيرات جديدة لآليات الأمراض.
وتظل هذه النتيجة مرتبطة بمدى دقة النماذج، وهي نقطة تسعى المبادرة إلى اختبارها من خلال إنتاج بيانات تجريبية واسعة ومتنوعة.
أول البيانات خلال عام
تتوقع المبادرة إنتاج أول مجموعة من البيانات خلال نحو عام، بينما تستهدف الوصول إلى نماذج تنبؤية وظيفية خلال فترة تصل إلى خمس سنوات.
ويعكس هذا الجدول الزمني طبيعة المشروع، إذ لا يتعلق الأمر بتدريب نموذج ذكاء اصطناعي تقليدي على بيانات موجودة، وإنما ببناء منظومة جديدة لجمع البيانات وتجاربها وتوحيدها وتحليلها.
وتحتاج هذه العملية إلى تطوير تقنيات قياس قادرة على العمل بسرعات ونطاقات أكبر، إلى جانب تطوير طرق لتخزين البيانات وربطها وتحويلها إلى صيغة يمكن للنماذج التعامل معها.
كما تحتاج إلى تعاون مستمر بين المختبرات والجامعات والمؤسسات الحكومية والشركات الخاصة.
البيانات ستصبح متاحة للباحثين
تصف Biohub المبادرة بأنها جهد مفتوح يهدف إلى إنشاء مورد يمكن للمجتمع البحثي العالمي استخدامه.
ووفق المعلومات المنشورة حول المبادرة، ستتم إتاحة البيانات بصورة أوسع للباحثين بعد فترة وصول أولية حصرية للشركاء التجاريين المشاركين في المشروع.
وتتيح هذه الآلية للشركات المشاركة تطوير أدواتها ونماذجها اعتماداً على البيانات الجديدة في المرحلة الأولى، مع الحفاظ على الهدف الأساسي المتمثل في بناء قاعدة بيانات يمكن أن يستفيد منها المجتمع العلمي على نطاق أوسع لاحقاً.
تحدي توحيد البيانات البيولوجية
لا تكمن صعوبة المشروع في حجم التمويل فقط.
فالبيانات البيولوجية التي تحتاج إليها النماذج موجودة بالفعل في مستودعات كثيرة حول العالم، لكنها غالباً ما تختلف في طرق جمعها وقياسها ووصفها.
وقد تكون مجموعة البيانات مفيدة لباحث متخصص، لكنها تحتاج إلى إعادة تنظيم وتوصيف حتى تصبح قابلة للاستخدام في تدريب نموذج ذكاء اصطناعي.
ولهذا تمثل عملية standardization جزءاً أساسياً من دور Biohub وNIH داخل المبادرة.
وكلما أصبحت البيانات أكثر اتساقاً، زادت قدرة النماذج على ربط النتائج بالتدخلات المختلفة، بدلاً من التعامل مع كل مجموعة بيانات باعتبارها نظاماً منفصلاً.
سباق جديد بين AI والدواء
لا تأتي مبادرة Biohub في فراغ، إذ يتزايد اهتمام شركات الذكاء الاصطناعي بتطبيق نماذجها على العلوم والطب واكتشاف الأدوية.
وتحاول شركات مختلفة بناء أنظمة قادرة على فهم البروتينات والجزيئات والخلايا، ثم استخدام هذه القدرات لتسريع اكتشاف علاجات جديدة.
لكن معظم هذه المشاريع تصطدم بمشكلة واحدة: البيانات التجريبية عالية الجودة لا تتوافر دائماً بالحجم والتنوع المطلوبين.
ومن هنا يمكن أن يمثل مشروع Virtual Biology Initiative محاولة لبناء طبقة بيانات مشتركة تسمح للعديد من النماذج والمختبرات بالاستفادة من نفس الأساس العلمي.
مشروع يتجاوز الشركات
تختلف المبادرة عن مشاريع الذكاء الاصطناعي التجارية التقليدية بسبب اتساع الأطراف المشاركة فيها.
فالمشروع يجمع مؤسسة بحثية غير ربحية مع وكالات حكومية أمريكية وشركات تكنولوجيا عالمية وشركة متخصصة في اكتشاف الأدوية.
ويعني ذلك أن البنية التي يجري بناؤها لا تعتمد على شركة واحدة أو مختبر واحد، وإنما على مجموعة من المؤسسات التي تقدم تمويلاً وبيانات وقدرات حوسبة وتقنيات قياس.
وتعتقد Biohub أن بناء نموذج تنبؤي دقيق للبيولوجيا يحتاج إلى مستوى من التعاون لا تستطيع مؤسسة منفردة تحقيقه، وهو ما يفسر الدعوة إلى مشاركة المجتمع العلمي العالمي في المشروع.
الولايات المتحدة تراهن على AI للعلوم
يحمل المشروع أيضاً بعداً استراتيجياً بالنسبة إلى الولايات المتحدة.
فمشاركة DOE وNIH تعني وضع جزء من البنية العلمية والحاسوبية الحكومية خلف مشروع يستهدف تطوير الذكاء الاصطناعي للبيولوجيا.
وتوفر المختبرات الوطنية الأمريكية إمكانات كبيرة في الحوسبة والتصوير والعلوم التجريبية، فيما تمتلك NIH واحدة من أكبر قواعد البيانات والموارد البحثية الطبية في العالم.
ومن خلال الجمع بين هذه الإمكانات وشركات الذكاء الاصطناعي، تحاول الولايات المتحدة بناء منظومة بحثية قادرة على تسريع استخدام الذكاء الاصطناعي في التكنولوجيا الحيوية والطب.
من نماذج اللغة إلى نماذج الحياة
تمثل المبادرة خطوة في اتجاه أوسع داخل صناعة الذكاء الاصطناعي، يتمثل في الانتقال من النماذج التي تتعامل مع اللغة والصور إلى نماذج تحاول فهم الأنظمة الطبيعية نفسها.
فاللغة يمكن تمثيلها من خلال نصوص ضخمة، بينما تحتاج البيولوجيا إلى بيانات تجريبية تصف ما يحدث داخل نظام حي في ظروف مختلفة.
وهذا يجعل تطوير نموذج للبيولوجيا أكثر اعتماداً على العلوم التجريبية، وأقل ارتباطاً بالبيانات المتاحة على الإنترنت فقط.
وتسعى Biohub وشركاؤها إلى معالجة هذه المشكلة من جذورها من خلال بناء أدوات قادرة على إنتاج بيانات جديدة على نطاق واسع.
التمويل لا يضمن نجاح النموذج
رغم ضخامة المبادرة، فإن حجم الاستثمار لا يعني تلقائياً الوصول إلى نموذج قادر على التنبؤ بكل ما يحدث داخل الخلية.
فالبيولوجيا واحدة من أكثر الأنظمة تعقيداً، والاستجابة لدواء أو تغير جيني يمكن أن تختلف باختلاف نوع الخلية والظروف والسياق البيولوجي.
كما أن البيانات الجديدة تحتاج إلى التحقق من جودتها ودقتها، والنماذج تحتاج إلى اختبار نتائجها في تجارب مستقلة.
ولهذا سيكون نجاح المشروع مرتبطاً بقدرته على تحويل حجم البيانات الضخم إلى معلومات يمكن استخدامها فعلياً في التنبؤ، وليس فقط إنتاج مستودع هائل من البيانات.
خمس سنوات لاختبار الرؤية
تضع Biohub وشركاؤها إطاراً زمنياً يصل إلى خمس سنوات لتطوير التقنيات والبيانات والنماذج اللازمة لتحقيق الهدف الأكبر للمبادرة.
وخلال هذه الفترة ستحتاج الأطراف المشاركة إلى زيادة حجم البيانات، وتحسين تقنيات القياس، وتطوير طرق دمج البيانات متعددة الأنماط، وتدريب النماذج واختبارها على حالات بيولوجية حقيقية.
وستكون النتائج الأولى مهمة لتحديد ما إذا كانت البيولوجيا يمكن أن تستفيد من الزيادة المستمرة في البيانات والحوسبة بالطريقة التي استفادت بها مجالات أخرى من الذكاء الاصطناعي.
جولة


